单因子分析回答"这个因子有没有用",多因子分析回答三个更进一步的问题:这几个因子是不是在讲同一件事?该剔除谁、保留谁?能不能合成一个更好的?
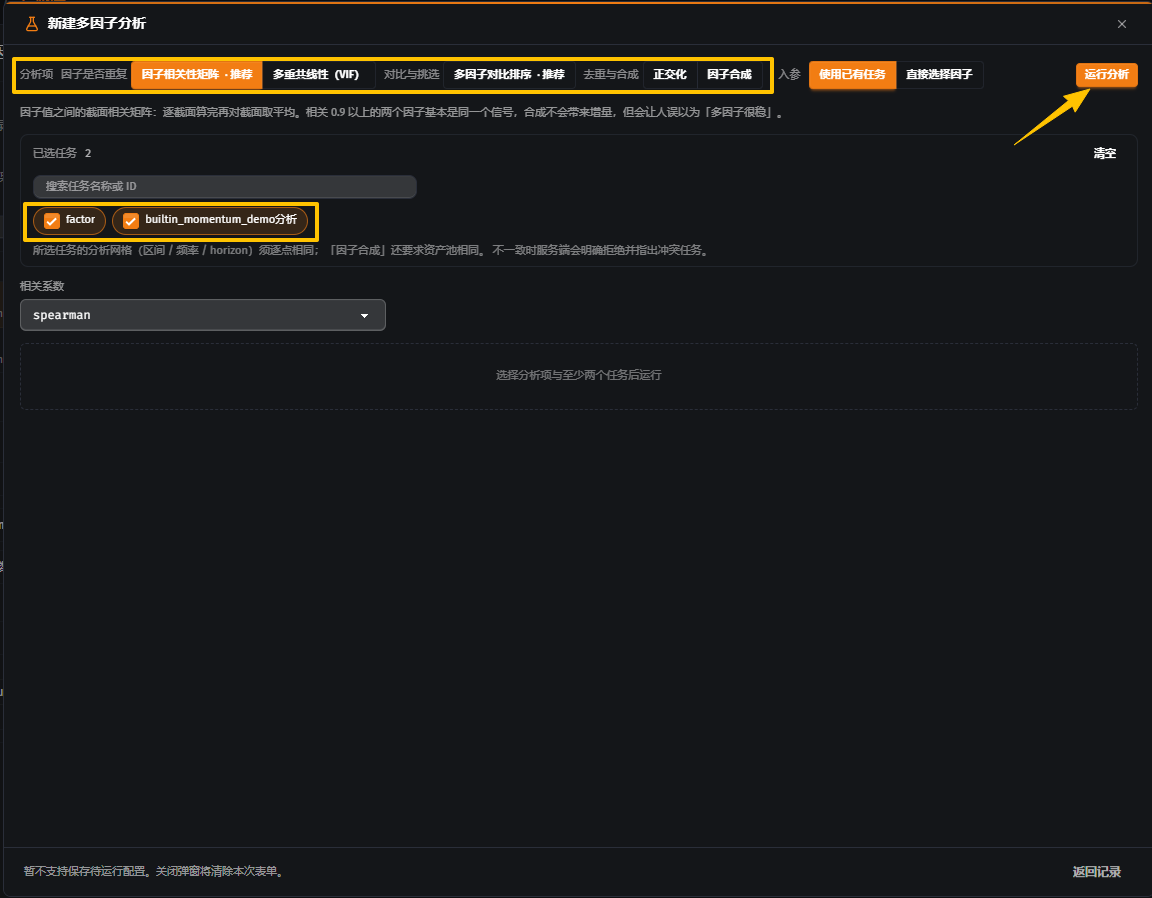
入口:因子分析页顶部切到"多因子"页签,点右上角新建按钮。
入参:两种起点
| 起点 | 做法 | 适用 |
|---|---|---|
| 使用已有任务 | 勾选已跑完的单因子任务(可按任务名或任务 ID 搜索),继承其全部口径 | 单因子检验已完成,要在同一口径下横向比较;结果可追溯到具体任务快照 |
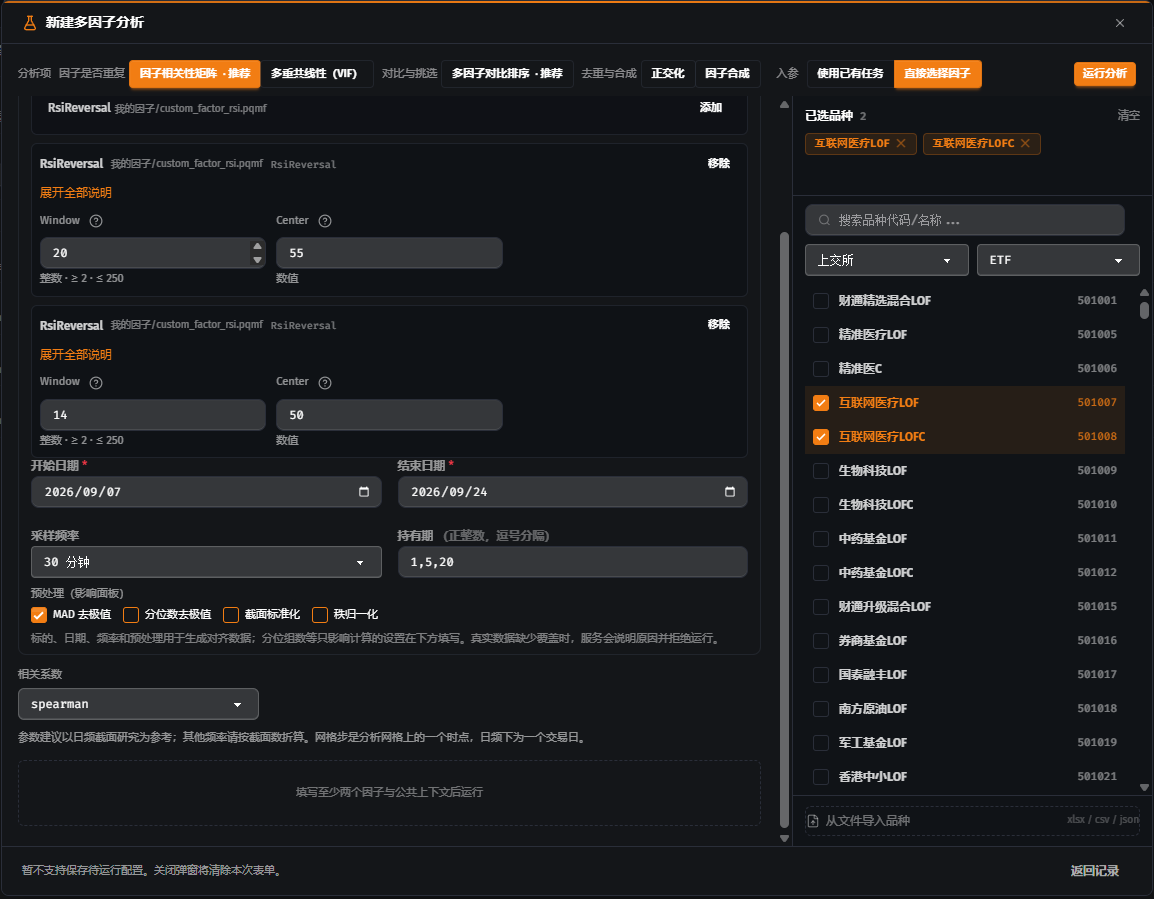
| 直接选择因子 | 现场选因子文件、填该因子自带参数,另设公共设置与品种池 | 还没跑单因子,先快速看相关性与共线性;或想临时调参对比 |
"直接选择因子"的每张卡片对应一个"因子 + 参数"组合:卡片头是因子类名、文件路径与类名,参数由因子自身定义(如 RSI 的 Window 为整数 2–250、Center 为数值),可"展开全部说明"查看。同一文件可以添加多张卡片,形成不同参数的多个实例。公共设置包括起止日期、采样频率、持有期(正整数逗号分隔),以及四项预处理——MAD 去极值 / 分位数去极值 / 截面标准化 / 秩归一化;界面提示:标的、日期、频率和预处理用于生成对齐数据;分位组数等只影响计算的设置会在下方填写。品种池在右侧面板选择,可按交易所与类型筛选、搜索代码或名称,也可从文件导入。
一致性约束(最容易踩的坑)
所选任务的分析网格——区间、频率、持有期——必须逐点相同;"因子合成"还要求资产池相同。不一致时服务端会明确拒绝,并指出具体是哪个任务冲突。另外,至少要选两个任务或两个因子才能运行,未选够时结果区显示"选择分析项与至少两个任务后运行"。
窗口底部有一句提醒:"暂不支持保存运行配置,关闭弹窗将清除本次表单"——多因子配置不会自动留存,换参数试算时请先用右上角"清空"把已选任务清掉,或重开窗口。
为什么必须一致:多因子分析是逐截面、逐时点做的对齐运算(求相关、取回归残差、加权求和),网格不同就不存在共同的截面;任何插值或重采样都会人为制造相关性,让结论失去意义。
五个分析项
界面按"要解决什么问题"把它们归成三组:因子是否重复(相关性矩阵、VIF)、对比与挑选(多因子对比排序)、去重与合成(正交化、因子合成)。带"推荐"标记的是常规流程的默认起点。
因子相关性矩阵(推荐)
做什么:逐截面计算两两因子的截面相关,再对所有截面取平均。界面说明原文——"因子值之间的截面相关矩阵:逐截面算完再对截面取平均。相关 0.9 以上的两个因子基本是同一个信号,合成不会带来增量,但会让人误以为「多因子很稳」。"
为什么先截面、后平均:因子值的绝对水平逐期漂移(标准化后每期均值都为 0),若把全样本摊平算相关,会被时序上的水平变化污染,得到虚高的相关。逐截面计算只保留"同一时点选股排序是否一致",这才是合成真正需要的信息。
参数:相关系数可选 spearman(秩相关,默认)或 pearson(原始值线性相关)。秩相关只看排序,抗极端值,因子分布偏斜时更可靠;pearson 受量纲与尾部影响,只在因子已标准化且近似正态时更合适。界面另有一句口径提示:参数建议以日频截面研究为参考,其他频率请按截面数折算——网格步是分析网格上的一个时点,日频下为一个交易日。
判读(按绝对值为准,符号另看):
| 绝对值 | 含义 | 处理 |
|---|---|---|
| ≥ 0.9 | 基本是同一个信号 | 只留一个(取 ICIR 更高的),或合成前先正交化 |
| 0.7–0.9 | 高度重叠 | 谨慎合成,权重会被重复信息主导 |
| 0.3–0.7 | 中等相关 | 可同时保留,是多因子的常见区间 |
| < 0.3 | 基本独立 | 理想组合对象,合成后 ICIR 才有提升空间 |
符号同样重要:负相关表示两个因子方向相反(一个追涨、一个杀跌),等权相加会互相抵消。合成前必须先统一方向(对因子值取负),或改用带符号的权重,否则合成结果会莫名其妙地接近 0。
多重共线性(VIF)
做什么:把每个因子对其余因子做截面回归,VIF = 1 / (1 − R²),衡量"这个因子的信息有多少能被别人解释"。
与相关矩阵的分工:相关矩阵只看两两,VIF 看"一对多"——三个因子两两相关只有 0.5,叠加起来 VIF 也可能超过 5。判断整体是否冗余看 VIF,判断谁和谁重复看相关矩阵。
判读:VIF = 1 完全无共线;大于 5 提示共线明显;大于 10 属严重共线。后果是回归类合成的权重估计方差爆炸、符号甚至翻转——等权合成不受数学影响,但等于对同一个信号重复下注,风险被放大。
多因子对比排序(推荐)
做什么:对每个因子各跑一遍完整的单因子检验(同区间、同频率、同持有期、同分组),把 IC 均值、ICIR、t 值、换手、多空等指标排成一张表,默认按 ICIR 排序。
为什么按 ICIR 而不是 IC 均值:IC 均值给强度,ICIR 给稳定性;强度相同的两个因子,更稳的那个在实盘里更可靠。选因子的一般顺序是——先看显著性(Newey-West t 值),再看 ICIR,最后看相关性(避免选两个一样的),同分时选换手更低的(成本更小)。
注意:排序是样本内的相对排名,不等于未来预期;只有同区间、同品种池的对比才有意义。
正交化
做什么:按给定顺序,把后一个因子对前面已保留的因子做截面回归,取残差作为新因子。第一个因子原样保留——顺序就是优先级。
数学上:f_k⊥ = f_k − β · F_prev,β 由当期截面估计,残差与前面的因子线性无关,因此只携带增量信息。
效果与代价:正交化后因子的方差变小、噪声占比上升,IC 往往下降——这不是因子变差,而是"净贡献"的真实大小。如果相关矩阵显示绝对值已超过 0.9,正交化后的残差基本就是噪声,此时该做的是剔除而不是正交化。
注意:顺序决定结果,应按业务逻辑排(先放最基础、最可信的因子);正交化后的因子不再具备原始经济含义,解释时要说明"这是剔除某某之后的部分"。
因子合成
做什么:把多个因子按权重逐截面加权成一个复合因子,再把它当作单因子重跑完整检验。
权重方式:equal 等权;ic 按历史 IC 加权;icir 按历史 ICIR 加权;max_icir 求使合成 ICIR 最大的权重。权重只能用已经实现的历史 IC / ICIR,按滚动窗口估计,不能使用当期或未来信息——这也是合成结果前期会有一段预热空白的原因。
怎么选:等权最稳健、不易过拟合,因子数量少时通常够用;IC / ICIR 加权能自适应因子强弱,但权重本身是估计量,因子多、样本短时噪声大,容易出现权重集中到一两个因子上;max_icir 拟合并最重,只有样本足够长时才建议用。
前提与验证:合成前必须先看相关矩阵——高度相关的因子先剔除或正交化,否则合成只是把同一个信号加权平均,ICIR 不会提升。合成后要重跑单因子分析(IC、ICIR、分组单调性、换手),确认复合因子确实优于最好的单因子;通常合成因子的换手低于成员因子,因为信号被平滑。
结果与留档
运行完成后详情页顶部显示"分析已完成 · 已留档"与耗时(示例 13 909 ms)。
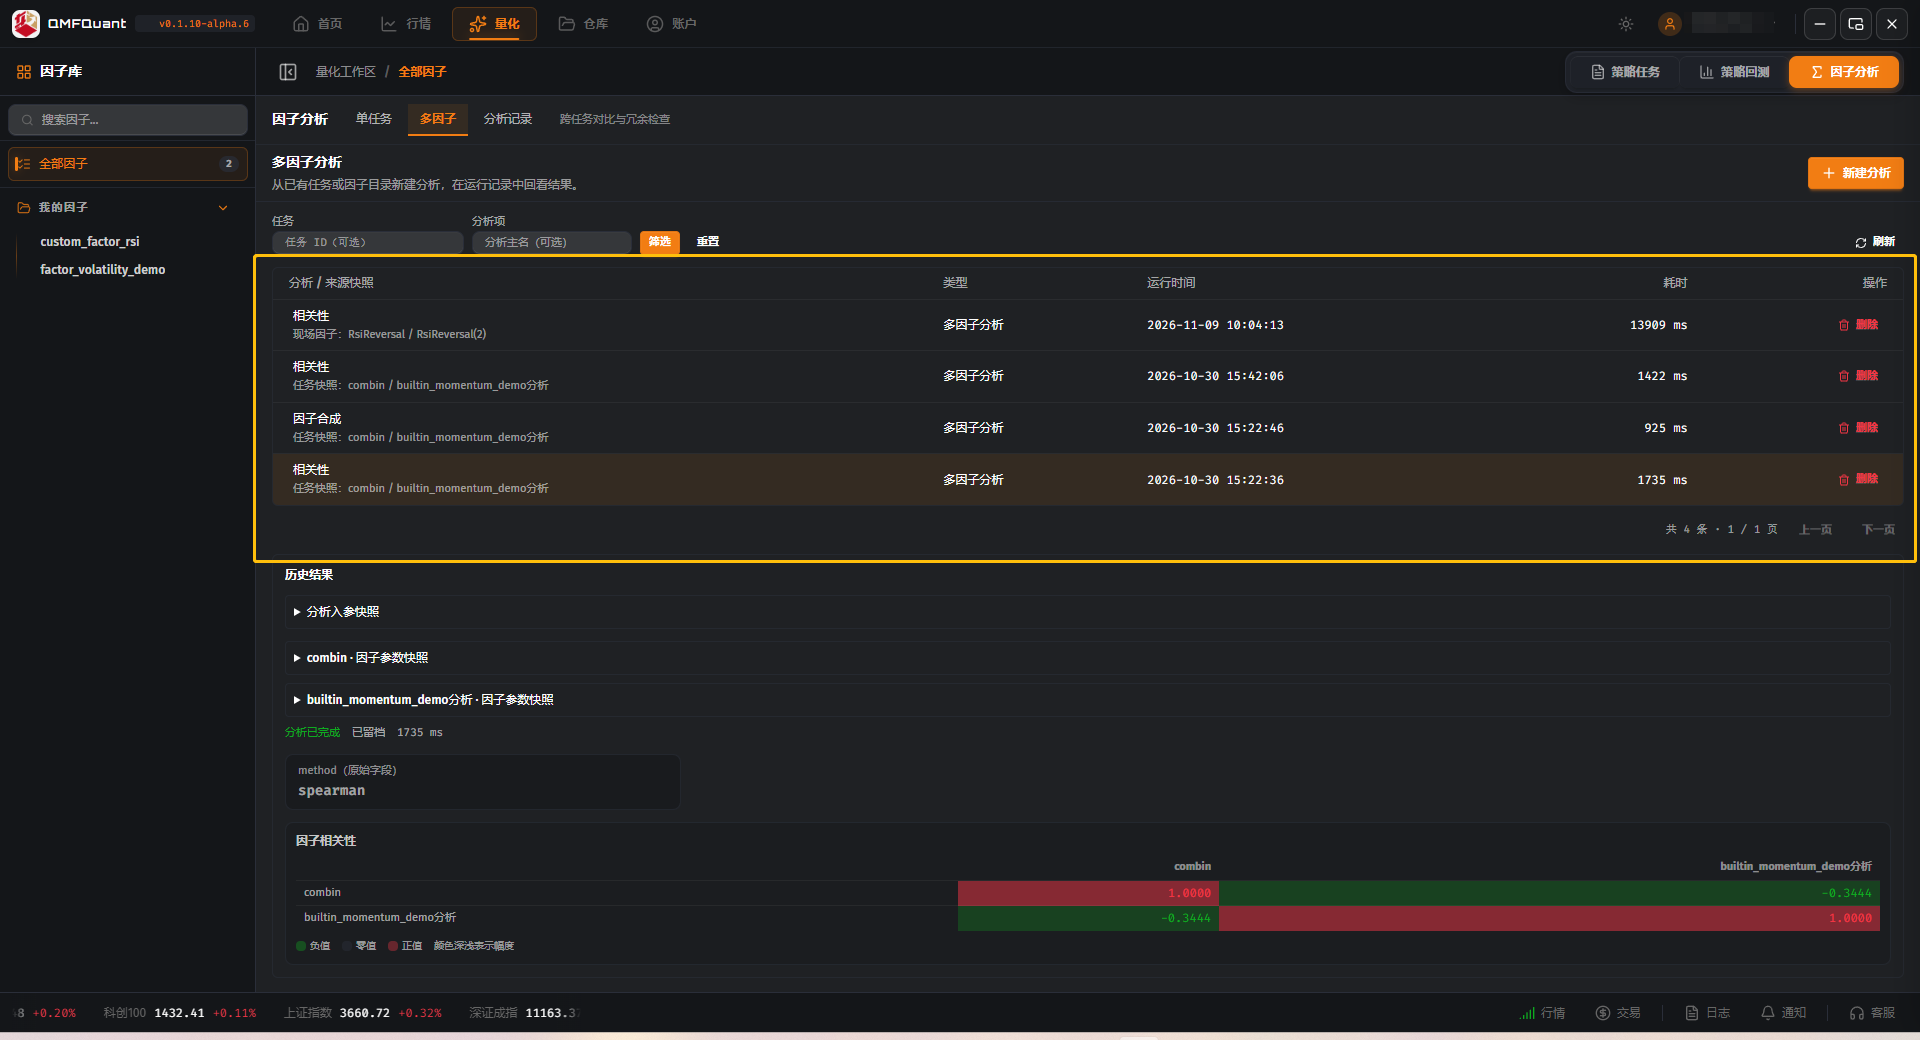
相关性以热力图呈现:行、列都是因子名(同一因子多次入参自动编号 RsiReversal / RsiReversal(2)),对角线恒为 1.0000;图例为"负值 / 零值 / 正值,颜色深浅表示幅度"——按 A 股习惯正相关为红、负相关为绿,缺失或未计算的格子显示"—"。示例中两张卡片实为同一因子(同文件、同类、同参数),相互比较的交叉格显示"—"而未给数值——碰到这种情况先确认自己是否把同一个因子重复入参了,这正是"因子是否重复"这项分析要提示的情形。
历史记录按分析项分组保存在左侧,每条标明"分析 / 来源快照",右侧列表给耗时与删除操作,可刷新。换参数重跑不会覆盖旧记录,方便对照。
三个常见误判
| 现象 | 原因 | 处理 |
|---|---|---|
| 相关矩阵大片"—",或数值只在 ±1 之间跳变 | 截面只有两三个标的,秩相关自由度不足 | 多因子分析对截面宽度最敏感,建议在标的数 ≥ 25 的任务上做 |
| 相关性时高时低,均值却"看起来还行" | 相关是逐截面平均,会掩盖市场状态切换(危机时同涨同跌) | 分市场状态或滚动窗口看,不要只信一个均值 |
| 合成后 ICIR 没提升甚至下降 | 成员因子高度相关,或成员本身 ICIR 很低 | 先看相关矩阵与对比排序,剔除冗余与弱因子 |
相关阅读
评论
登录后参与讨论,与站内账号体系共用。